Fewer Tokens, More Self-Teaching: On-Policy Self-Distillation for Extreme Visual Token Reduction
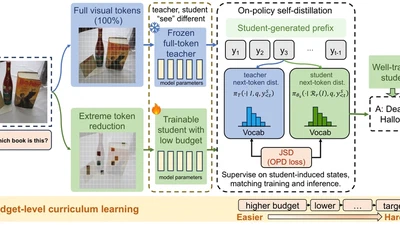
Recovering multimodal capabilities under extreme visual-token reduction through on-policy self-distillation and a progressive token-budget curriculum.

I am Ruixuan Yang, an undergraduate in the School of Mathematics and Statistics at Xi’an Jiaotong University (XJTU). I’m interested in Model Efficiency, Multimodal LLMs (MLLMs), Post-training & Reasoning, etc.
I am currently a visiting student in Prof. Yulun Zhang’s group at Shanghai Jiao Tong University and Prof. Huan Wang’s ENCODE Lab at Westlake University.
Recovering multimodal capabilities under extreme visual-token reduction through on-policy self-distillation and a progressive token-budget curriculum.
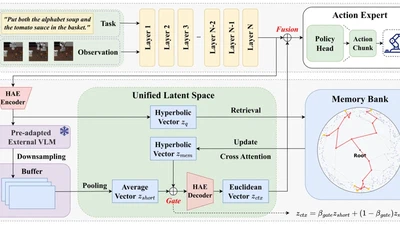
Organizing robot experiences in a continuous hierarchical memory to support retrieval and generalization in long-horizon tasks.
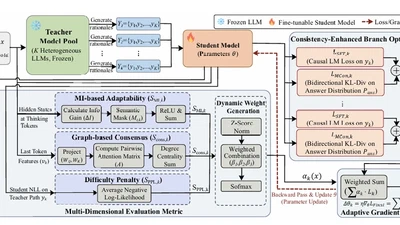
Combining complementary teachers through student-aware supervision for more effective reasoning distillation.
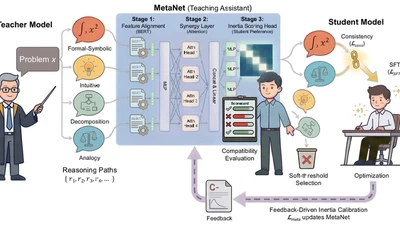
Aligning diverse reasoning perspectives with the student's evolving capabilities to move beyond passive imitation.